引言
提笔,这篇文章我打算不做过多铺陈与抒情,仅仅陈述一些我的经验和一些事实。也可以概括为一些方法论和少许世界观。
粗缯
从一个copilot到chatbot,再从chatbot到agent,不过短短数年(从具备工具性的时刻开始算起),《Attention Is All You Need》由谷歌八人团队首先提出,OpenAI 随即沿着这条路做出了“GPT-3”,一脚踹开了ai时代的大门。2025年,agent变成了编辑器的终极形态,把 cursor 这类工具甩在了身后。
但是,国内的一些不好的东西冒了出来,兹举数例:
- 国内内存条相关概念起飞,ddr4和ddr5等消费级内存被囤积居奇。实则货源充足、供需稳定,三星、美光、海力士收紧对华出口只是被拿来当由头,存量并没有被真正消化,涨价系炒作;
- 国内自媒体炒作概念,背后既有云服务商的推手,也有国内产商搭售和产品经理炒作,哗众取宠,事实上许多东西都是炒冷饭和重复造轮子(这个其实可以单开一页了);
- 盲目推崇或者神化单个符号或者公司及其产品,甚至借此牟利(虽然普及常识也功不可没,但是过大于功),大多是中转站之流所为。
以上三点,并不是我的全部陈词,但是足见2026年的荒诞了——今年三月 openclaw 爆火、五月即遭舆论与政策封杀,两个月走完一轮大倒车;七月 Anthropic 全面封禁中国 ip;八月中网红产品经理“阿酥”被起底;还有横跨半年的内存涨价潮、笔记本厂商倒吸牙膏、tibo 74小时内重置3次额度——
在当前的条件下,假设你是一个2025年跨入大学校园的普通学生,如果你选择了一个性能本,很抱歉,你被踢出局了;如果你选择了macbook,恭喜,你选择了最有性价比的笔记本;如果你携带自己的主机进入学校,恭喜,你选择了最具有潜力的系统;如果你带着你的RTX 5060laptop到RTX 5070laptop版本的笔记本,开黑一边玩去吧……
注:这里能否部署说的是指非垂直领域的通用模型,如果参量够小或者量化版本足够小性能本其实可以运行,或者embedding模型其实门槛比较低,但是由于限制很大,不做建议;另外mac性价比高是建立在你的预算实在有限,并且没有强烈的游戏需求时的权宜选择,它能提供宽裕的统一内存,但是在速度上会比NVIDIA的RTX系列慢许多。正文为个人观点,请谨慎辨别。
种种客观情况虽然不尽理想,但是并不是无法逾越的。
百衲
目前所有模型的分水岭参量大致有三档:
- 个人部署:0.5B – 40B;
- 小规模工作站/实验室部署 :100B – 400B;
- 大规模服务器集群: 700B – 3T;
上面三档说的是模型自身的参数量级,然而能不能用得起来是另一回事:本地跑不出 27B 这个量级,基本就可以视为不可用。所以没有高端主机或者mac生态,基本就可以告别有实际意义的本地部署了——即使量化后也是不可逾越的门槛。
即使种种限制让我们沮丧,但是我们仍然可以获取廉价的api,从而感受到ai发展的速度给我们创作和工作带来的便利。前几日deepseek v4.1 flash 、glm 5.3 flash 、qwen3.8 flash next 的发布将小模型带到了新的高度,我们都可以获得更快更便宜的 token ,而个人能力的增长,放在 ai 的增速旁边,就显得捉襟见肘。即使是在目前,以Agent + Harness + 长上下文 + CoT 的范式,随着数据质量、模型深度、上下文长度不断继续扩展(scale),AI 的能力也将稳步前进。因此在旧的社会运转方式日趋解体的当下,我们更需要关注自身与ai的协同方式。
我在此转载一个发表于公众号上的文章的例子:
-
现在的学生是不是大概率会更倾向于使用 AI 完成作业,特别是偏向于实践的各种 Lab?想象一下,如果面前有两个选择,一个是苦哈哈地用八小时时间完成一个 Lab,或许还拿不到满分;另一个则是启动 AI 模型,用几毛钱的成本、几分钟的时间,直接让 AI 编写满分代码,那大部分学生会选择哪个呢?
-
上面一点会导致大量学生的工程能力严重不足,包括组织代码的能力、构建系统的能力、思考未来潜在需求并提前在设计上应对的能力、抽象的能力等等。那么在 AI 能力不断变强的背景下,这部分“工程能力”是否还是必须的呢?这些工程能力是会向旧日的“熟练编写 x86 汇编”的能力那样逐渐被时代抛弃,还是会像“理解从软件到系统再到硬件的整套计算机系统”的能力那样永远具有价值?如果是后者的话,那就危险了 —— 一个工程能力很差的人,在搭配上 AI 后,产出屎山的效率可以达到先前的数倍,进而给系统埋下各式祸患,让这个世界变得更加草台。
我再引一条证据。github 官方对八月那次事故的复盘里,给了一组平台活动量的曲线——一边是持续攀升的提交、合并请求与新增仓库:
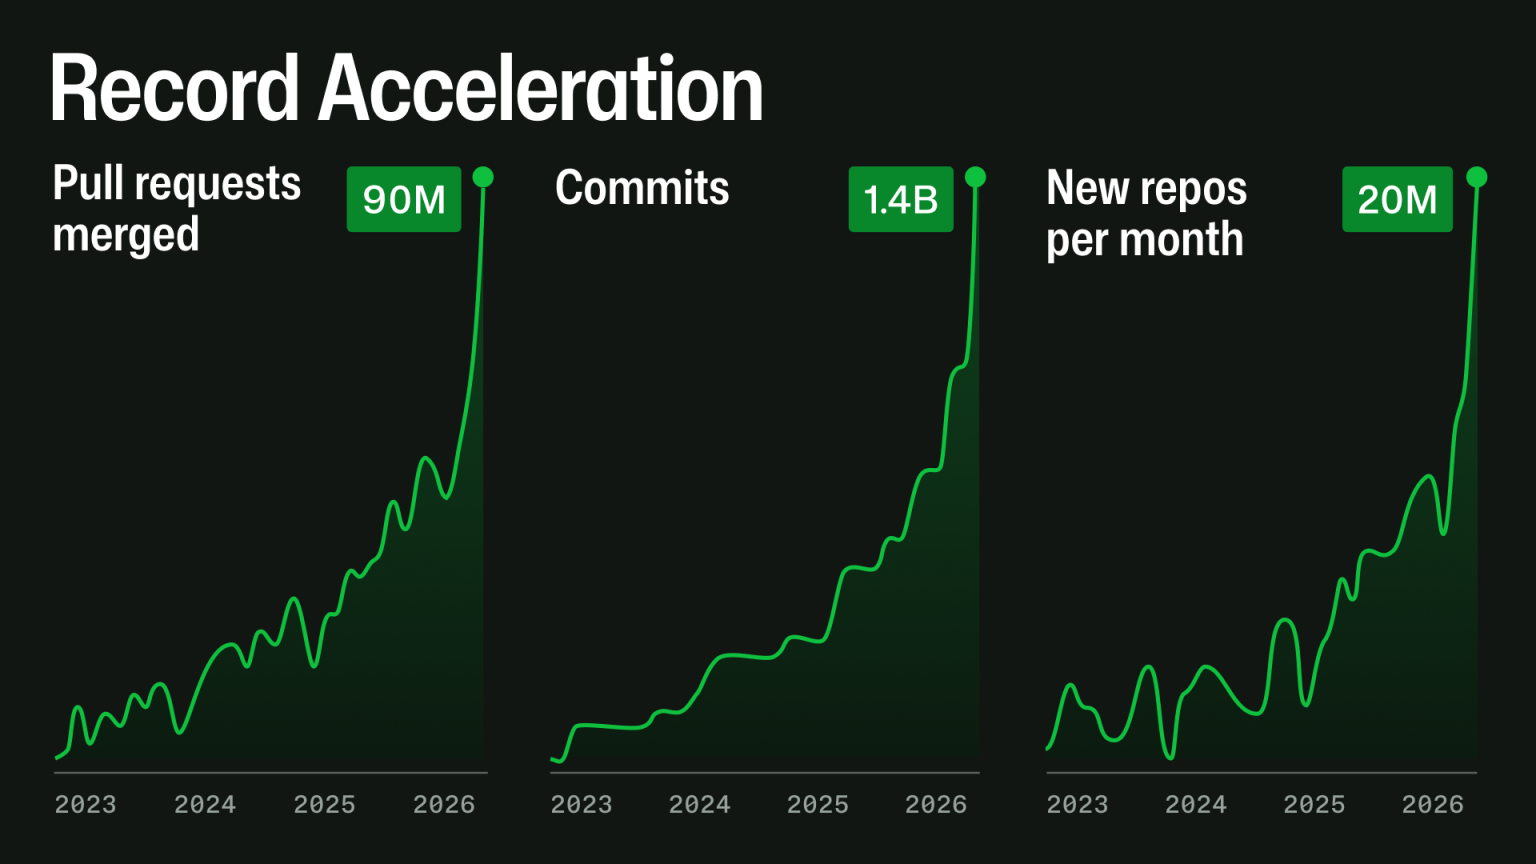
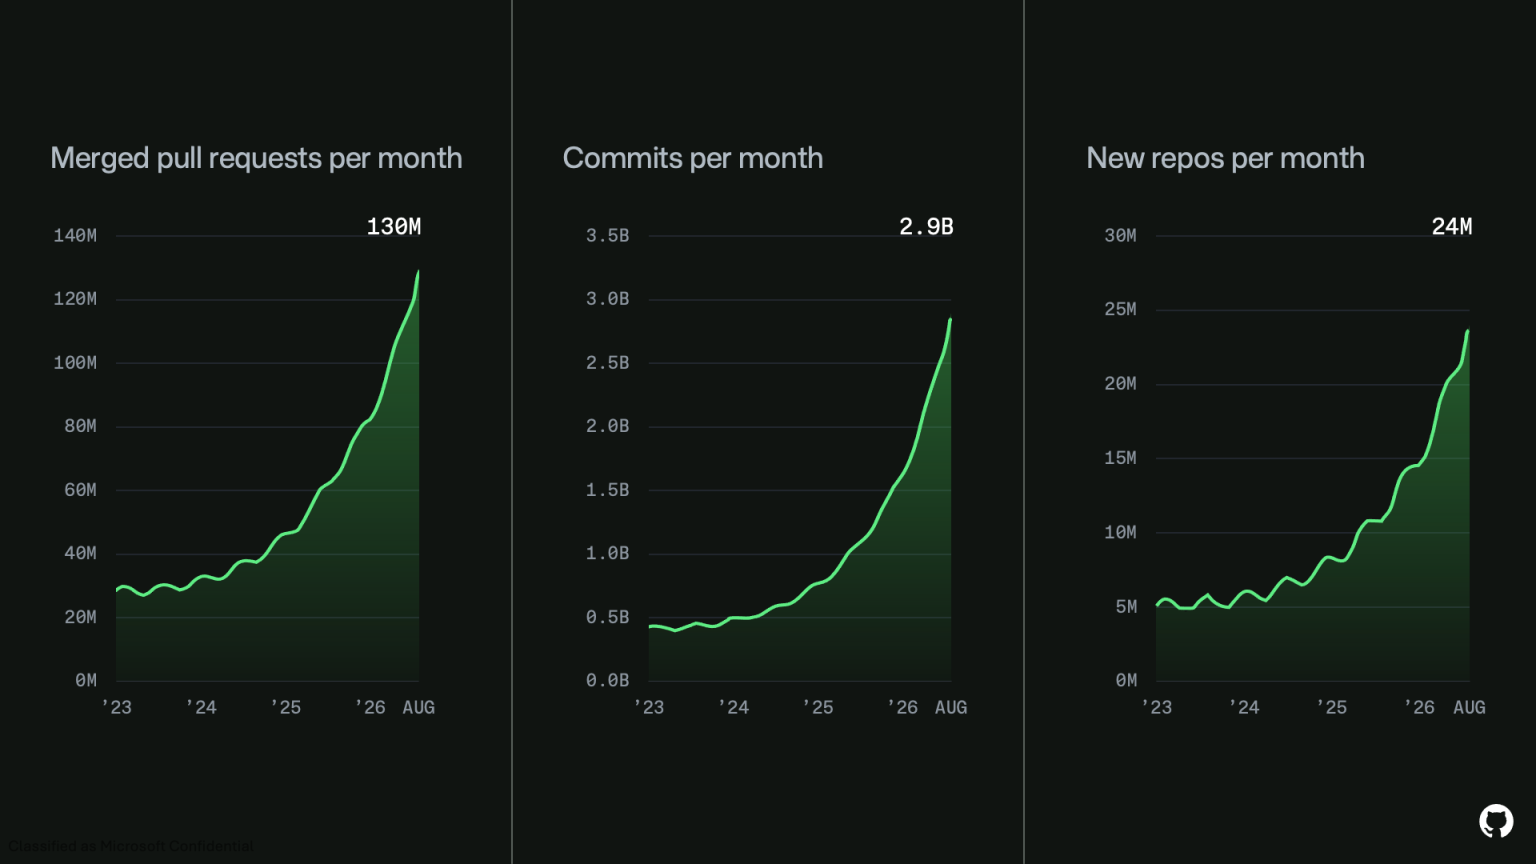
另一边,同一时期主要服务出过一次故障,原表述为:
“On August 17, GitHub experienced an outage that lasted 7 hours and 47 minutes. It disrupted github.com, authentication, GitHub Actions, APIs, pull requests, issues, and Copilot, affecting developers and organizations around the world. If you were trying to ship software that day, we let you down.”
这种无序的野蛮生长,既有对岸那边政治与商业集团的媾和做推手,也有此岸在规范政策落地之前踩踏式地争抢、嘴里揩油,媒体嘴中的妖风不应该把判断的方向吹得东倒西歪,不是所有人都需要做自己的“产品经理”,而且无意义的重复造轮子也会占用大量公共资源:
这笔代价,数据上已经看得见了——多样性坍塌与探索带宽收窄,都已被实证。Doshi 与 Hauser 的随机对照实验(Science Advances, 2024)发现,AI 辅助让个体作品更受好评,却让作品彼此更相似——作者称其为“社会困境”:对个人理性,对集体损耗。Hao 等人对 4,130 万篇论文的分析(Nature, 2026)则给出了量级:AI 使用者的产出是同行 3.02 倍、引用 4.84 倍,但科学界研究的主题总量收缩 4.63%、科学家互动下降 22%,形成“孤独的人群”。个体效率的提升与集体探索空间的收缩,在同一组数据里同时成立。
这一规律并非文学或科学界独有。软件工程的证据同样指向趋同:Burtch 对 Kaggle 2019–2026 年提交的分析显示,AI 编程助手的普及使代码在句法层面的变异维度显著收窄(effective rank 从约 33 降至约 28),到 2026 年中,带随机种子的提交中超过 95% 都使用同一个值。(Burtch, The Hitchhiker’s Guide to Monoculture, arXiv:2607.13077, 2026,预印本)
而我们现在正在学校里的大学生所能做的就是守住我们的思考能力。在ai冲击旧有秩序的时候,个人的能力边界极大延伸,但是实际上这里要打一个“引号”:我们不能将外物的能力作为自己的能力,至少我们要有同等的经验,去做人工的审核,避免无意义的重复产出,从而抽出精力去做真正需要创造的事,并且堵住垃圾的源头。甚至于说,在此之外,我们更应该关注自身的心理和身体健康,而不是去参与一些无意义的文化消费。
成衣
在高度扁平、快节奏的文化消费时代,片面的符号化消费与商品完成绑定,所有人概莫能外。随着媒介技术的不断发展,人们接收信息、认知事物的方式变得日益窄化。基于标签与画像的分发模式,将所有人围困在同质化严重的信息茧房里,原本多元的声音渐弱为单一音节,判断对错的标准扭曲成“异己”与“非异己”。于是,一座又一座巴别塔在无形中拔地而起,人们自以为向上的攀登,最终都通向了狭隘封闭的单向度空间。
“露从今夜白,月是故乡明。”今天八月初七,小雨润如酥,梧桐飘黄。前几日,地上就有落下的梧桐叶了,风吹起来或是踩上去,沙沙的。重阳木垂下穗状的果实,熟透的红色浆果在地面作画,午后的阳光慵懒,透过叶间的缝隙,向大地栽种白昼。白云柔软,飞鸟朝蓝,让人忘掉所有烦扰。
“凡是过往,皆为序章”——莎翁曾言。